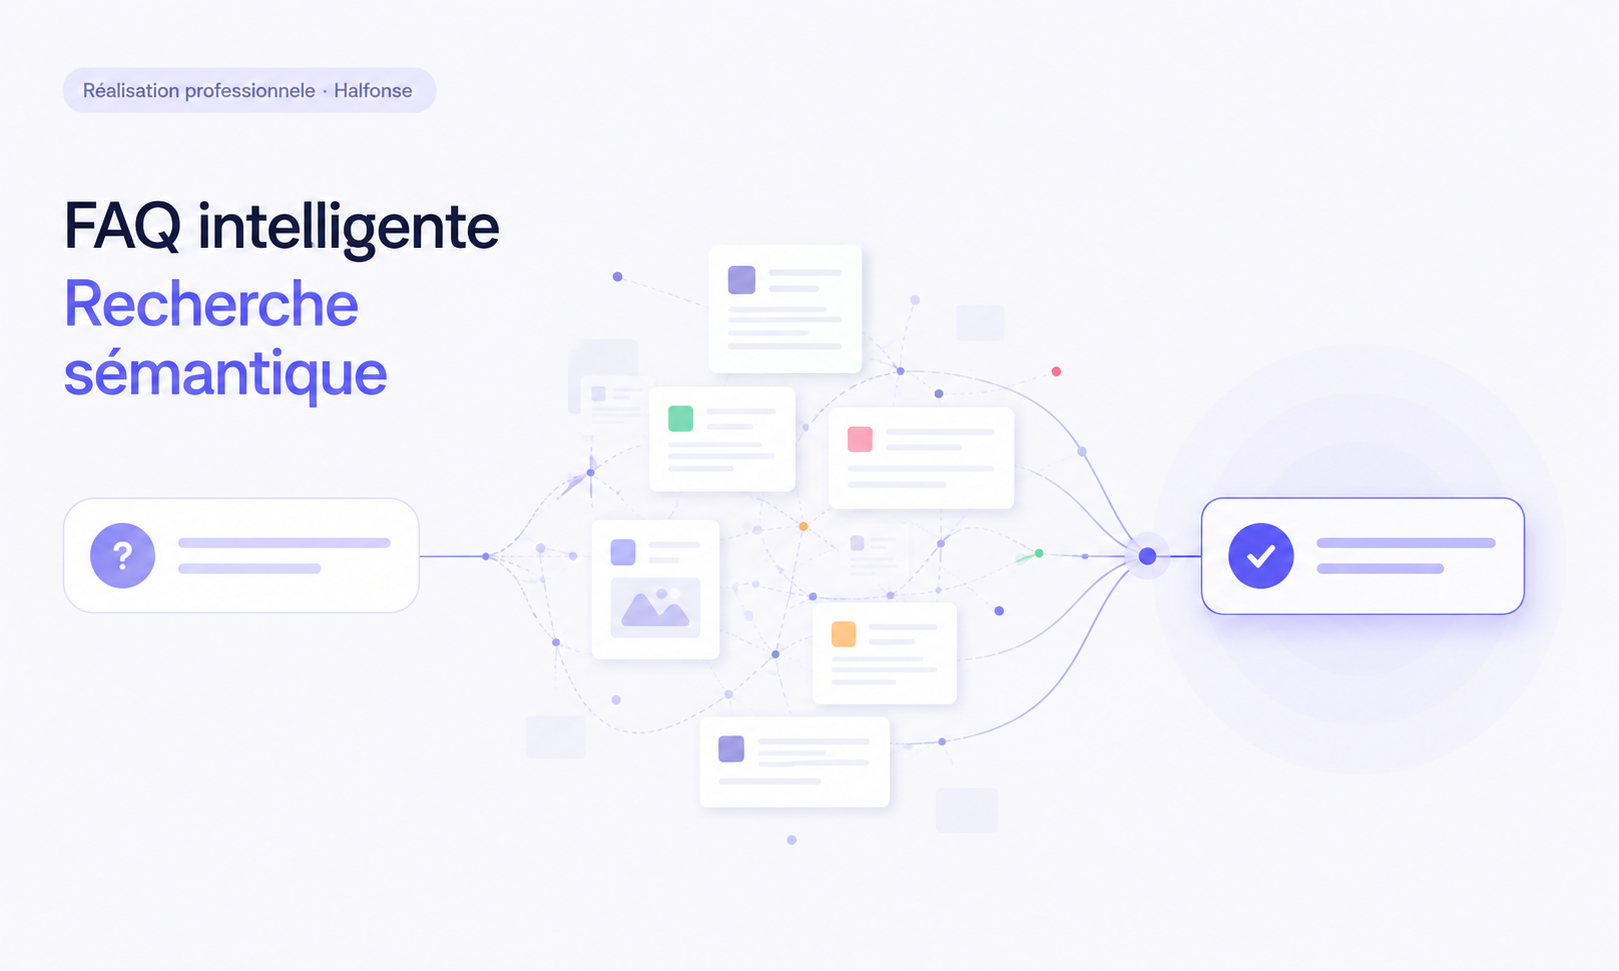
FAQ intelligente avec embeddings
Contexte
Absence totale de FAQ : impossible pour les utilisateurs de faire une recherche d'information, et l'équipe support recevait trop de questions répétitives. Objectif : créer un assistant capable de comprendre les questions en langage naturel et de trouver les réponses dans la base de données interne à Bubble.
Défi technique
Bubble n'a pas de base vectorielle native. Pour limiter la dépendance à des outils tiers (type Pinecone ou Weaviate), tout devait être fait en Bubble et JavaScript custom.
Solution
Chaque entrée FAQ est convertie en vecteur via l'API OpenAI et stockée dans un champ texte Bubble. Un script custom calcule la similarité cosinus entre la question de l'utilisateur vectorisée et l'ensemble des entrées FAQ déjà vectorisées, avec streaming de la réponse pour une UX réactive. Un dashboard admin simple permet d'ajouter ou modifier les FAQ, avec génération automatique des embeddings à la sauvegarde.
Résultats
Gain de temps significatif côté support, onboarding interne facilité (la FAQ devient la source unique de vérité), système évolutif sans intervention technique pour ajouter du contenu, et architecture réutilisable pour d'autres cas RAG internes.
Ce que j'ai appris
La performance d'un système RAG dépend plus de la qualité du retrieval que du LLM lui-même, un contexte mal filtré augmente le risque d'hallucination. Il a fallu itérer sur le nombre de résultats retournés (3 vs 5 vs 10), le prompt système pour limiter les hallucinations, et la structure des FAQ (titre et contenu séparés).
Faq workflow avec script
Interface utilisateur