Contexte
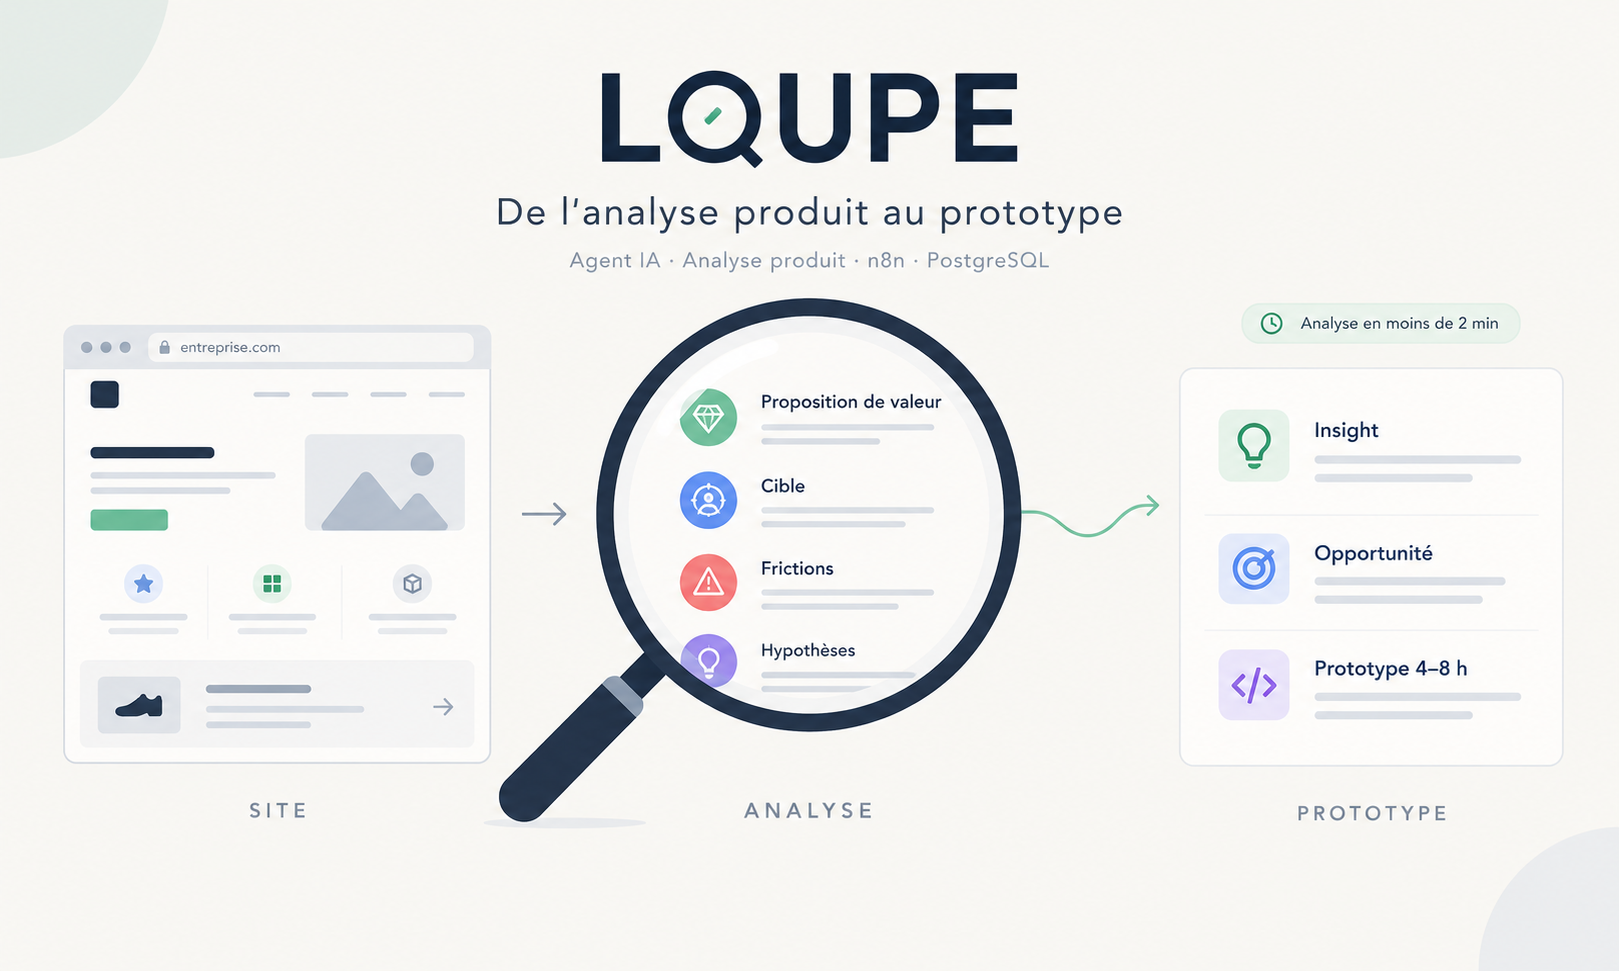
Avant un rendez-vous, un partenariat ou une analyse concurrentielle, comprendre le produit d'une entreprise prend souvent une heure de navigation, pour n'en tirer que quelques intuitions éparses. Loupe automatise ce travail : on lui donne un nom, une URL et, si on le souhaite, un contexte (pays, secteurs visés, priorités). Un agent explore le site et relève ce que l'entreprise propose déjà ; un second modèle rédige un rapport : lecture du marché, points forts, pistes de développement et spécification d'un prototype réalisable en une journée.
Conception produit, architecture, développement et tests, de l'idée au MVP puis à une v2 affinée par des retours de lecteurs et mesurée sur un jeu de test, avec Claude Code.
Ce que produit une analyse
- Une synthèse et la proposition de valeur de l'entreprise.
- Une lecture du marché : segment, cible, positionnement, différenciation, modèle économique et tendances du secteur, ces dernières clairement signalées comme hors site analysé.
- Des points forts, chacun relié à la page qui l'appuie.
- Trois pistes de développement, chacune avec ce qui existe déjà sur le site et ce qu'elle apporte de nouveau, notées en impact et en effort.
- Un encadré « Périmètre de l'analyse », qui indique les angles du contexte que le site public ne permet pas de voir, plutôt que de les inventer.
- Un proof-of-work : la meilleure piste devient la spécification d'un prototype, avec périmètre, étapes chiffrées une à une, stack et critère de succès vérifiable.
Le tout est livré dans un rapport mis en page, consultable à l'écran et enregistrable en PDF A4. Le ton est volontairement constructif : on reconnaît d'abord ce que l'entreprise fait bien, et les pistes sont des hypothèses à discuter.
Exemple concret : un rapport sur une entreprise anonymisée (PDF).
Architecture
Deux workflows n8n, et deux modèles qui ont chacun leur rôle :
- Exploration (gpt-5-mini) : l'agent choisit et lit jusqu'à 4 pages par ordre de priorité, puis dresse l'inventaire de l'existant, chaque élément accompagné d'une citation exacte de sa page. L'outil de lecture renvoie un message court pour une page en erreur ou un fichier, au lieu de leur contenu.
- Rédaction (gpt-6.1-sol) : analyse, marché et pistes, rédigés à partir de l'inventaire et du texte des pages.
- Contrôles : vérifications par code (citations présentes dans la page, sigles absents du texte source, somme des heures) et relecture critique des pistes par un modèle.
- Proof-of-work (gpt-6.1-sol) : spécification du prototype, avec une boucle de réduction du périmètre si le total dépasse 8 heures.
Un second workflow sert le rapport HTML imprimable. Les analyses sont stockées dans PostgreSQL avec l'inventaire, les pages lues, les tokens consommés, le coût estimé et les avertissements. Les modèles autorisés sont fixés par une liste blanche : tout autre modèle fait échouer l'analyse. L'ensemble tourne dans Docker Compose, avec une version de n8n épinglée.
Fiabilité : faire confiance à un rapport généré
L'essentiel du travail de la v2 a porté sur une question : comment éviter qu'un LLM produise un rapport plausible mais faux ?
- Rien d'affirmé sans source. Aucune norme, aucun organisme ni aucune obligation légale ne peut être cité s'il ne figure pas dans les pages lues. Le contexte fourni oriente les choix, mais n'est jamais présenté comme une information sur le marché.
- L'existant d'abord. L'inventaire, fondé sur des citations vérifiées par code, est dressé avant les pistes. Chaque piste doit dire ce qui existe déjà et ce qu'elle ajoute, et la relecture critique signale celles qui reprennent l'existant.
- Des contrôles déterministes. Les vérifications par code (citations, sigles, durée) donnent toujours le même verdict, contrairement à un contrôle par modèle. Elles restent la base, la relecture par modèle vient en complément.
- Un prototype réaliste. Le proof-of-work ne reconstruit jamais la technologie cœur de l'entreprise : il illustre un apport produit. La durée est calculée à partir des étapes, et au-delà de 8 heures le modèle doit retirer des éléments du périmètre.
- Des erreurs toujours explicites. Site protégé, adresse introuvable, délai dépassé, page en erreur ou fichier au lieu d'une page : chaque cas aboutit à un message clair, et aucune analyse ne reste bloquée.
Choisir le modèle sur des mesures
Plutôt que de choisir un modèle par intuition, j'ai comparé les configurations sur un jeu de test de cinq entreprises de secteurs variés, avec un tableau comparatif après chaque modification.
| Mesure | gpt-5-mini seul | Exploration gpt-5-mini, rédaction gpt-6.1-sol |
|---|---|---|
| Avertissements par analyse (sigles non sourcés…) | jusqu'à 7 | 0 à 1 |
| Anglicismes détectés | 1 à 5 | 0 |
| Première estimation du prototype | 21 à 36 h | 10,5 à 14 h |
| Durée d'une analyse | 33 à 53 s | 75 à 115 s |
Le modèle plus fort supprimait à lui seul des défauts que plusieurs itérations de prompts n'avaient pas éliminés. Mais il coûtait plus cher : 0,09 à 0,17 $ par analyse au premier essai. J'ai alors simplifié l'architecture : l'agent d'exploration ne rédige plus d'analyse que le modèle fort réécrivait, et les pages en erreur ne sont plus transmises en entier. Sur le cas le plus coûteux, les tokens d'entrée sont passés de 315 000 à 71 000 et le coût de 0,17 $ à 0,09 $. Un modèle plus cher, mais un système moins cher, parce que l'architecture a été adaptée en conséquence.
Choix et arbitrages
| Décision | Alternative écartée | Raison |
|---|---|---|
| Deux modèles : petit pour explorer, plus fort pour rédiger | Un seul modèle partout | La lecture consomme le plus de texte ; la rédaction demande le plus de nuance |
| Liste blanche de modèles et seuil d'alerte de coût | Modèle libre | Aucune analyse ne peut partir sur un modèle coûteux par erreur |
| Contrôles par code en premier | Tout confier à un modèle juge | Verdict reproductible et gratuit ; le juge vient en complément |
| Entrée manuelle, contexte optionnel | Détection automatique de signaux | Sources instables, scraping fragile ; reporté |
| 4 pages par ordre de priorité | Exploration libre | Durée et coût maîtrisés, résultats plus reproductibles |
| Respect des protections anti-bot | Les contourner | Fragile et contraire à la volonté des sites ; l'échec devient un message clair |
| Rapport HTML imprimable | Génération PDF côté serveur | Aucun service supplémentaire à maintenir |
| Durée calculée à partir des étapes | Durée estimée par le modèle | Le modèle écrivait « 6 h » à chaque fois ; le chiffre est désormais vérifiable |
Itérer sur des retours réels
La v2 est née de relectures du rapport par des lecteurs exigeants. Chaque retour a été traité comme un défaut de système, pas comme une correction de texte : réglementaire inventé (règle de sourçage et vérificateur), contexte recyclé comme un fait (séparation entre orientation et information), durée figée (calcul par étapes), prototype qui refaisait le produit de l'entreprise (règle sur la technologie cœur), pistes qui reprenaient des fonctionnalités existantes (inventaire cité et relecture critique). Une fois les règles stabilisées, le choix du modèle a été mesuré, puis l'architecture simplifiée pour en maîtriser le coût.
Méthode de travail avec Claude Code
Claude Code a construit et fait évoluer les workflows à partir de spécifications écrites. Mon rôle : cadrer, arbitrer, tester, valider.
- Un
CLAUDE.mdfixe les règles du dépôt ; une spécification par version décrit les changements, le hors périmètre et la définition de « terminé ». - Des règles explicites : workflows créés inactifs, aucun secret versionné, aucune modification de l'infrastructure sans autorisation, et aucun appel à un modèle payant au-delà de ce qui est demandé sans accord préalable et estimation du coût.
- L'instance n8n reste la source de vérité (synchronisation par API) : chaque version validée est exportée et versionnée dans Git, un commit par modification validée.
- Un jeu de test versionné et un script de comparaison permettent de mesurer chaque changement plutôt que de le juger sur un seul exemple.
Limites et suite
Les sites qui génèrent leur contenu en JavaScript peuvent ne livrer qu'une page quasi vide, les sites protégés ne sont pas analysables (par choix), et l'analyse repose sur le seul site public : ce qui n'est visible qu'après inscription ou dans les outils internes reste hors de portée, et l'encadré « Périmètre de l'analyse » le signale. La relecture critique, faite par un modèle, ne donne pas toujours le même verdict d'une exécution à l'autre.
Prochaines étapes : recherche web pour sourcer le contexte de marché, détection de signaux (levées de fonds, lancements, recrutements) et exposition en serveur MCP pour appeler Loupe depuis un assistant comme Claude.
Architecture
Scenario n8n analyse
Scenario n8n rapport